Prilikom izrade web sajta postoji mnogo tehničkih detalja koji nisu vidljivi posetiocima, ali imaju važnu ulogu u pravilnom funkcionisanju sajta i njegovoj vidljivosti na Google-u. Jedan od njih je robots.txt fajl.
Iako je reč o jednostavnom tekstualnom fajlu, njegova uloga je veoma značajna. On daje instrukcije robotima pretraživača, kao što je Googlebot, o tome kojim delovima sajta mogu da pristupe, a koje delove ne bi trebalo da posećuju.
Pravilno podešen robots.txt može pomoći u boljoj kontroli načina na koji pretraživači obilaze sajt. Sa druge strane, pogrešna podešavanja mogu sprečiti Google da pristupi važnim stranicama i njihovom sadržaju.
U nastavku objašnjavamo šta je robots.txt, šta sadrži, gde se postavlja i na šta treba obratiti pažnju prilikom njegove izrade.
Šta je robots.txt fajl?
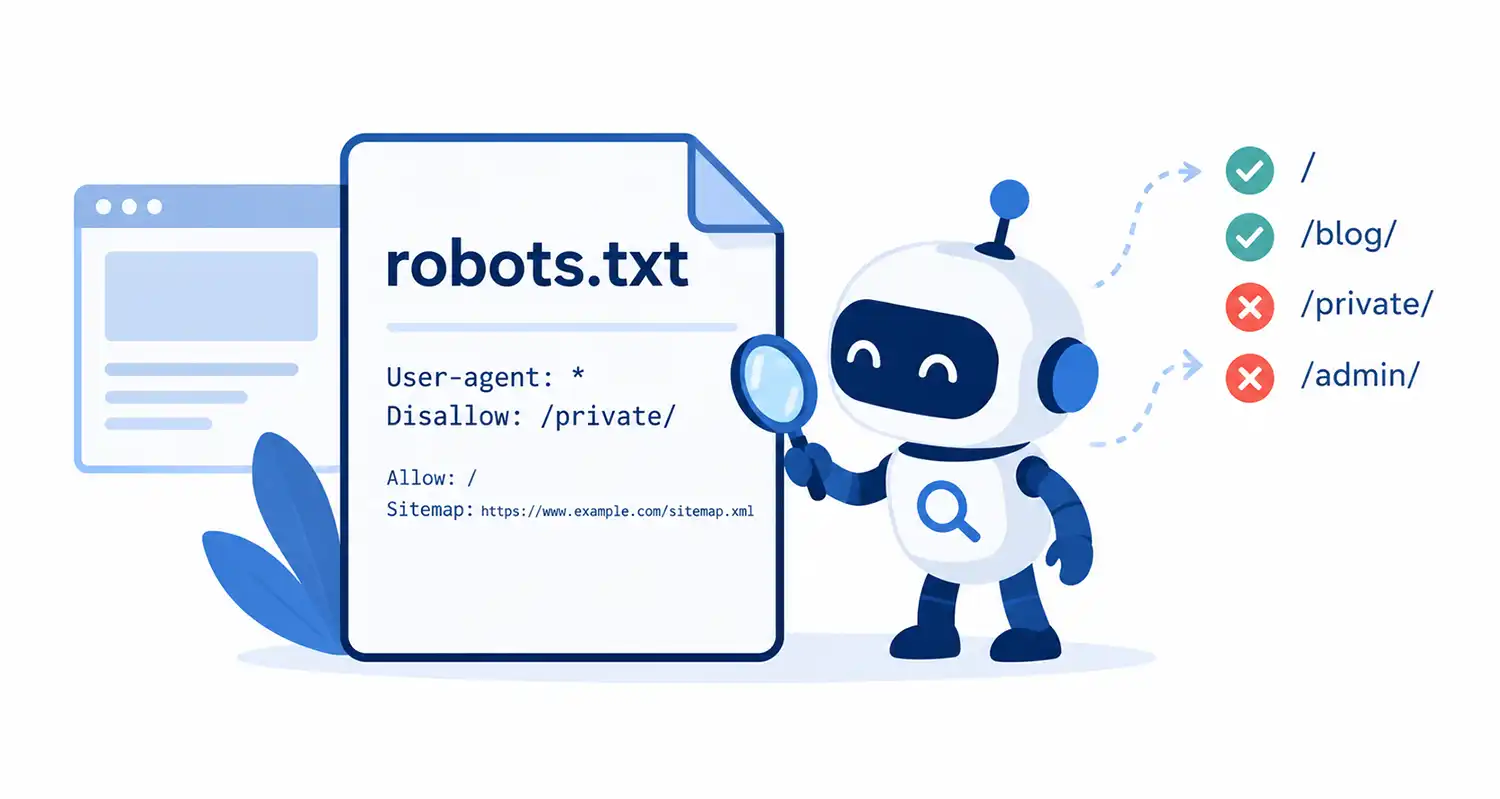
Robots.txt je običan tekstualni fajl koji se nalazi u glavnom direktorijumu web sajta i sadrži instrukcije namenjene automatizovanim programima koji posećuju sajt.
Takvi programi nazivaju se botovi ili web crawler-i. Koriste ih Google, Bing i drugi pretraživači kako bi otkrili i analizirali sadržaj na internetu.
Kada Googlebot želi da poseti neki sajt, najpre proverava da li postoji robots.txt fajl i čita pravila koja su u njemu definisana.
Na osnovu tih pravila može da utvrdi kojim delovima sajta je dozvoljeno da pristupi, a koje direktorijume ili URL adrese treba da preskoči.
Na primer, vlasnik sajta može dozvoliti pretraživačima pristup svim javnim stranicama, ali ograničiti pristup određenim tehničkim direktorijumima koji nisu namenjeni posetiocima.
Važno je razumeti da robots.txt nije namenjen običnim posetiocima sajta. On služi za komunikaciju sa automatizovanim programima.
Čemu služi robots.txt?
Osnovna namena robots.txt fajla jeste kontrola pristupa web crawler-a različitim delovima sajta.
Njegova upotreba može biti korisna u nekoliko situacija:
- Kontrola pristupa direktorijumima – moguće je ograničiti pretraživačima pristup određenim delovima sajta.
- Sprečavanje nepotrebnog crawlovanja – botovima se mogu ograničiti URL adrese koje nemaju značaj za prikazivanje u rezultatima pretrage.
- Upravljanje pristupom tehničkim stranicama – moguće je definisati pravila za određene sistemske direktorijume.
- Navođenje XML sitemap fajla – pretraživačima se može ukazati na lokaciju XML mape sajta.
- Kontrola opterećenja servera – kod velikih sajtova pravila mogu pomoći u upravljanju nepotrebnim zahtevima crawler-a.
Kod manjih prezentacionih sajtova robots.txt može biti veoma jednostavan. Kod velikih portala i internet prodavnica njegova konfiguracija može biti znatno složenija.
Šta sadrži robots.txt fajl?
Robots.txt koristi jednostavnu sintaksu. Pravila se definišu pomoću nekoliko osnovnih direktiva.
Najvažnije su:
User-agent
Određuje na koje botove se odnose pravila.
Na primer:
User-agent: *
Zvezdica označava sve crawler-e koji poštuju ovu vrstu pravila.
Disallow
Ova direktiva označava putanju kojoj crawler ne bi trebalo da pristupa.
Na primer:
Disallow: /wp-admin/
Ovo pravilo ograničava pristup WordPress administratorskom direktorijumu.
Allow
Ova direktiva dozvoljava pristup određenoj putanji i može se koristiti kao izuzetak od šire zabrane.
Sitemap
Navodi lokaciju XML mape sajta, koja pretraživačima pomaže da otkriju važne URL adrese.
Na primer:
Sitemap: https://www.moj-sajt.rs/sitemap_index.xml
Lokacija sitemap fajla mora biti navedena kao puna URL adresa.
Primer robots.txt fajla
Jedan od jednostavnijih primera robots.txt fajla za WordPress sajt može izgledati ovako:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://www.moj-sajt.rs/sitemap_index.xml
Ovaj primer znači:
- Pravila se odnose na sve crawler-e.
- Pristup WordPress administratorskom direktorijumu nije dozvoljen.
- Izuzetak je
admin-ajax.php, kome je pristup dozvoljen. - Pretraživačima je navedena lokacija XML sitemap fajla.
Važno je napomenuti da je ovo samo primer. Svaki sajt ima drugačiju strukturu, pa robots.txt treba prilagoditi konkretnom projektu.
Nije dobro nasumično kopirati pravila sa drugog sajta jer ono što je odgovarajuće za jedan web sajt ne mora biti dobro rešenje za drugi.
Gde se postavlja robots.txt fajl?
Robots.txt se postavlja u glavni direktorijum sajta, odnosno u njegov root direktorijum.
To je isti direktorijum u kojem se obično nalaze osnovni WordPress fajlovi, kao što su wp-config.php, wp-content i wp-admin.
Na primer, ako je adresa vašeg sajta:
https://www.moj-sajt.rs
robots.txt fajl treba da bude dostupan na adresi:
https://www.moj-sajt.rs/robots.txt
Ne postavlja se u direktorijum teme, dodataka ili u neku podmapu sajta.
Fajl je potrebno sačuvati pod tačnim nazivom robots.txt, uz odgovarajuće tekstualno kodiranje, najčešće UTF-8.
Može se napraviti pomoću običnog tekst editora, a zatim postaviti na server putem FTP programa ili kroz File Manager u hosting kontrolnom panelu.
Kako napraviti robots.txt u WordPress-u?
Kod WordPress sajtova postoji nekoliko načina za podešavanje robots.txt fajla.
1. Direktno preko hosting naloga
Fajl se može napraviti ili izmeniti u glavnom direktorijumu WordPress instalacije, koristeći File Manager ili FTP pristup.
Ovo je direktan način i omogućava potpunu kontrolu nad sadržajem fajla.
2. Pomoću SEO dodataka
Pojedini SEO dodaci za WordPress omogućavaju pregled i uređivanje robots.txt pravila iz administratorskog panela.
Na taj način nije neophodno svaki put pristupati hosting nalogu.
3. Automatski generisan robots.txt
Ako fizički robots.txt fajl ne postoji, WordPress može generisati virtuelnu verziju prilikom zahteva za adresu /robots.txt.
To znači da sajt može imati funkcionalan robots.txt čak i kada ne postoji poseban fajl u glavnom direktorijumu.
Ukoliko se kasnije postavi fizički fajl, on može preuzeti kontrolu nad sadržajem koji se prikazuje na toj adresi.
Zbog toga je važno proveriti šta je zaista dostupno na adresi https://www.moj-sajt.rs/robots.txt, a ne pretpostaviti da fajl ne postoji samo zato što ga ne vidite u File Manager-u.
Da li robots.txt utiče na SEO optimizaciju?
Robots.txt ima važnu ulogu u tehničkom SEO-u, ali njegov uticaj treba pravilno razumeti.
Google koristi crawler-e za otkrivanje i obilazak stranica. Ako robots.txt zabrani pristup određenom delu sajta, Googlebot neće moći normalno da pregleda sadržaj na tim adresama.
Zbog toga je veoma važno da se ne blokiraju stranice koje želimo da Google pronađe, pročita i prikaže u rezultatima pretrage.
Na primer, ako se slučajno postavi pravilo:
User-agent: *
Disallow: /
ono znači da se svim crawler-ima zabranjuje pristup celom sajtu.
Takva greška može ozbiljno da ugrozi SEO vidljivost sajta.
Zato robots.txt treba proveriti nakon izrade sajta, ali i nakon svake veće izmene tehničke strukture.
Da li robots.txt sprečava Google da indeksira stranicu?
Ovo je jedna od najčešćih nedoumica.
Robots.txt i indeksiranje stranica nisu ista stvar.
Robots.txt prvenstveno kontroliše pristup crawler-a, odnosno crawlovanje. On nije pouzdan način da se određena stranica potpuno ukloni iz Google rezultata pretrage.
Ukoliko želite da sprečite indeksiranje određene stranice, obično se koristi noindex direktiva putem meta taga ili HTTP zaglavlja.
Da bi Google mogao da pročita noindex instrukciju, stranica mora biti dostupna crawler-u. Ako je istovremeno blokirana u robots.txt fajlu, Google možda neće moći da vidi tu instrukciju.
Takođe, URL adresa blokirane stranice i dalje može da se pojavi u rezultatima pretrage ako Google za nju sazna preko drugih stranica ili spoljašnjih linkova.
Zato robots.txt ne treba koristiti kao zamenu za zaštitu privatnih ili poverljivih podataka. Za takav sadržaj potrebno je koristiti odgovarajuću kontrolu pristupa, na primer lozinku ili autentifikaciju.
Najčešće greške prilikom podešavanja robots.txt fajla
Iako je fajl jednostavan, pogrešna pravila mogu napraviti ozbiljne probleme.
Najčešće greške su:
- blokiranje celog sajta umesto samo određenog direktorijuma
- zabrana pristupa važnim stranicama
- blokiranje CSS i JavaScript resursa koji su potrebni Google-u za pravilno prikazivanje stranice
- navođenje pogrešne lokacije sitemap fajla
- korišćenje robots.txt fajla kao zaštite privatnih podataka
- kopiranje pravila sa drugog sajta bez provere
- neproveravanje fajla nakon izmena na sajtu
Posebno treba obratiti pažnju na sajtove koji su u fazi izrade. Tokom razvoja često se privremeno ograničava pristup pretraživačima, ali se ta ograničenja moraju ukloniti pre objavljivanja sajta.
Kako proveriti da li je robots.txt pravilno podešen?
Najjednostavnija provera je da u internet pregledaču otvorite adresu:
https://www.moj-sajt.rs/robots.txt
Na taj način možete videti sadržaj fajla koji je trenutno dostupan na sajtu.
Za detaljniju proveru mogu se koristiti Google Search Console alati, uključujući URL Inspection, kako bi se proverilo da li Google može da pristupi važnim stranicama i pravilno ih obradi.
Preporučljivo je proveriti robots.txt nakon njegovog kreiranja, posle većih tehničkih izmena i kada se primete problemi sa crawlovanjem stranica.
Kako mi vodimo računa o robots.txt fajlu prilikom izrade sajta?
Prilikom izrade web sajta ne obraćamo pažnju samo na dizajn, sadržaj i funkcionalnosti. Važan deo posla je i pravilno tehničko podešavanje sajta kako bi pretraživači mogli da pristupe sadržaju koji treba da bude vidljiv na Google-u.
Zato proveravamo i robots.txt fajl, njegovu lokaciju i pravila koja sadrži.
U zavisnosti od projekta, vodimo računa o:
- pravilnom podešavanju pristupa crawler-a
- zaštiti od nepotrebnog crawlovanja određenih URL adresa
- dostupnosti važnih stranica za pretraživače
- pravilnom navođenju XML sitemap fajla
- proveri robots.txt pravila nakon objavljivanja sajta
- usklađivanju tehničkih podešavanja sa SEO strategijom
Naš cilj je da sajt bude pravilno postavljen ne samo za posetioce, već i za pretraživače koji treba da otkriju i analiziraju njegov sadržaj.
Zaključak
Robots.txt je mali, ali važan deo tehničke strukture svakog web sajta.
Njegova uloga je da pretraživačima pruži instrukcije o tome kojim delovima sajta mogu da pristupe. Pravilnim podešavanjem moguće je bolje kontrolisati crawlovanje i pomoći da se pažnja crawler-a usmeri na relevantan sadržaj.
Ipak, pogrešna pravila mogu napraviti probleme i ograničiti pristup stranicama koje želimo da budu vidljive na Google-u.
Zato robots.txt treba posmatrati kao deo šire tehničke SEO optimizacije, zajedno sa XML sitemap fajlom, pravilnom strukturom URL adresa, meta oznakama i drugim važnim elementima.
Planirate izradu novog sajta ili želite da poboljšate postojeći?
Tehnička podešavanja često nisu vidljiva posetiocima, ali mogu imati veliki značaj za pravilno funkcionisanje sajta i njegovu vidljivost na Google-u.
U našoj agenciji vodimo računa o detaljima koji čine razliku – od kvalitetnog dizajna i funkcionalnosti, do tehničke optimizacije i SEO podešavanja.
Bilo da vam je potreban novi prezentacioni sajt, poslovni web sajt ili WooCommerce internet prodavnica, možemo vam pomoći da dobijete profesionalno rešenje koje je spremno za dalji razvoj i online poslovanje.
👉 Kontaktirajte nas i zatražite ponudu za izradu sajta.